
In vigore la rimodulazione fiscale stabilita dal Decreto-Legge n. 162. Prezzi medi alla pompa oltre i 2 euro, attesa per lo scudo tariffario sui punti vendita Eni. Roma, 26 settembre 2026 Si apre una settimana cruciale sul fronte dei prezzi dei carburanti in Italia. A partire da oggi, sabato 26 settembre, entra ufficialmente in vigore la riduzione dell'agevolazione fiscale sul gasolio, come previsto dal decreto-legge 17 settembre 2026, n. 162. L'accisa sul diesel sale da 572,90 a 622,90 euro per mille litri, una misura che resterà attiva fino al prossimo 5 ottobre. La rimodulazione si inserisce in un contesto di forte pressione sui prezzi alla pompa. Secondo gli ultimi rilevamenti del Ministero delle Imprese e del Made in Italy, le medie nazionali in modalità self service si attestano a: Benzina: 2,158 euro/litro (2,252 euro/litro in autostrada) Gasolio: 2,357 euro/litro (2,439 euro/litro in autostrada) La contromossa di Eni: scatta il price cap da lunedì Per mitigare l’impatto sui consumatori, Eni ha annunciato l'introduzione di un tetto massimo ai prezzi (price cap) che diventerà operativo da lunedì 28 settembre. La misura prevede il blocco delle tariffe massime entro i seguenti limiti sulla propria rete: Tetto Benzina: 1,99 euro/litro Tetto Gasolio: 2,19 euro/litro L'intervento mira a offrire una rete di protezione immediata agli automobilisti di fronte ai rincari record, in attesa dei prossimi sviluppi normativi e del monitoraggio quotidiano dei prezzi ministeriali.
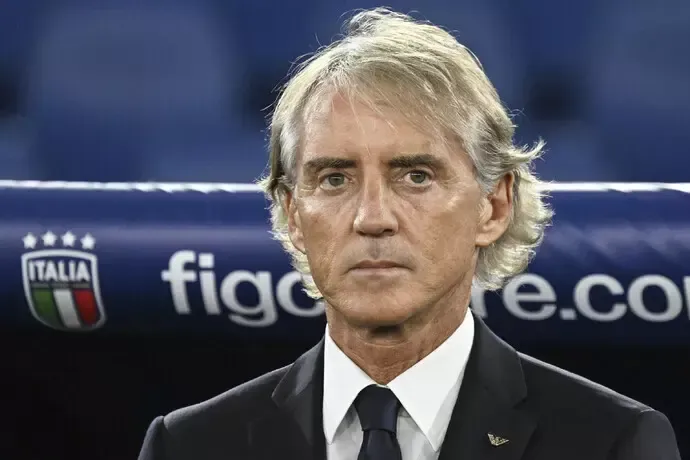
Dopo il passo falso all'esordio contro il Belgio (0-2 allo Stadio Olimpico di Roma), la Nazionale Italiana è pronta a volare alla volta di Bursa per affrontare la Turchia di Vincenzo Montella, match valido per la seconda giornata della Nations League 2026-2027. I n vista dei prossimi e ravvicinati impegni del Gruppo A1 – che vedranno gli Azzurri impegnati anche a Parigi contro la Francia – il Commissario Tecnico Roberto Mancini ha optato per una gestione strategica delle forze, decidendo di dividere il gruppo dei 33 convocati. Una delegazione di 23 calciatori partirà per la trasferta in Turchia, mentre 10 giocatori rimarranno a Coverciano per seguire un programma di allenamento personalizzato insieme a una parte dello staff tecnico e medico. All'elenco dei rimanenti si aggiunge l'assenza di Nicolò Zaniolo, il quale ha già dovuto lasciare anticipatamente il ritiro a causa di un infortunio. Di seguito l'elenco ufficiale dei 10 calciatori che non prenderanno parte alla trasferta e resteranno ad allenarsi presso il Centro Tecnico Federale: Honest Ahanor Mohamed Alì Zoma Nicolò Barella Diego Coppola Samuele Inacio Eddy Kouadio Daniel Maldini Gianluca Mancini Massimo Pessina Samuele Ricci La squadra che volerà in Turchia cercherà l'immediato riscatto sul campo per muovere i primi passi nella classifica del girone.
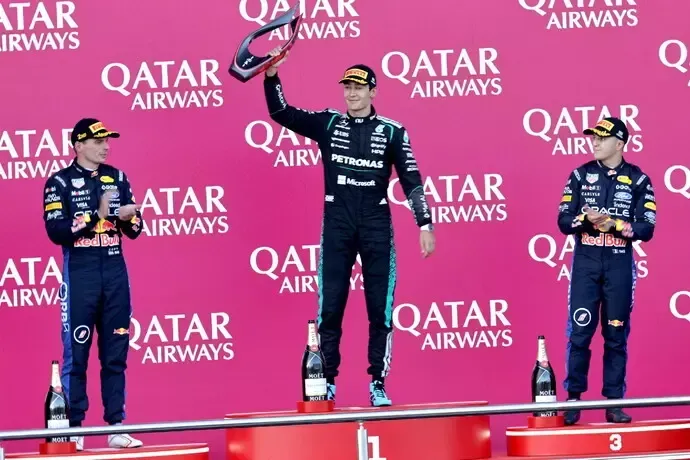
Podio per le due Red Bull di Verstappen e Hadjar. Quarto Leclerc con la Ferrari, sesto Hamilton. BAKU (Azerbaigian) – George Russell rispetta i pronostici della vigilia e conquista una splendida vittoria nel Gran Premio d'Azerbaigian, sul circuito cittadino di Baku. Il pilota britannico, al volante di una Mercedes impeccabile, ha imposto il proprio ritmo alla gara, tagliando il traguardo davanti alla concorrenza e confermando il momento di grande forma del team. Alle spalle del vincitore si è accesa la battaglia per i gradini più bassi del podio, che ha visto protagoniste le due Red Bull: Max Verstappen ha conquistato il secondo posto, seguito dal compagno di scuderia Isack Hadjar, autore di una solida prestazione che ha blindato il terzo gradino. I riflettori italiani sono stati tutti per Kimi Antonelli. Il giovane talento azzurro è stato autore dell'ennesima, spettacolare rimonta della sua stagione, risalendo lo schieramento con sorpassi decisi fino a conquistare un'ottima quinta posizione finale, confermando una maturità e una costanza straordinarie in pista. Domenica più opaca, invece, per la Ferrari. La scuderia di Maranello è rimasta parzialmente in ombra sul tracciato cittadino: Charles Leclerc ha chiuso ai piedi del podio con il quarto posto, senza mai riuscire a impensierire i leader della corsa, mentre Lewis Hamilton ha completato i punti per la scuderia concludendo in sesta posizione.
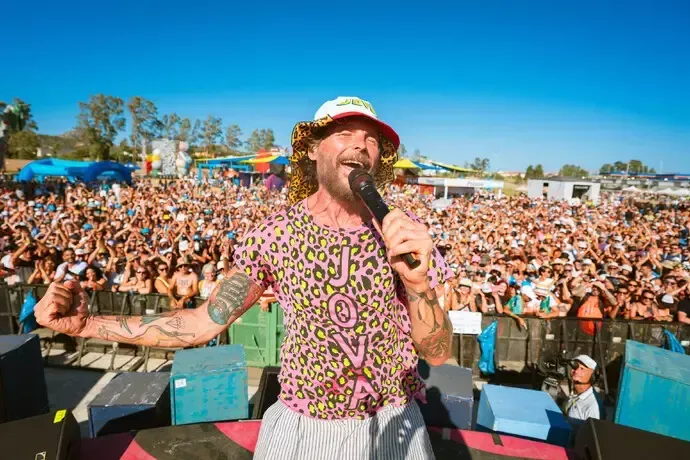
Lorenzo Cherubini, in arte Jovanotti, spegne oggi 60 candeline e traguarda un compleanno storico fedele alla sua natura: guardando solo al futuro. L'eterno ragazzo della musica italiana, con oltre quarant'anni di carriera alle spalle trascorsi tra rap, pop, world music e grandiosi tour negli stadi, ha confessato di non aver mai amato dare troppo peso a questa ricorrenza. " I 60 anni? Non ci penso proprio", ha confidato l'artista in occasione della tappa romana del suo Jova Summer Party. "Non ho mai festeggiato in maniera empatica perché di mestiere faccio le feste da quando ho 16 anni e dietro a una consolle, quindi il compleanno l'ho sempre ignorato. L'unico ricordo speciale era la telefonata al mio babbo, che compiva gli anni il giorno dopo il mio: univamo le ricorrenze ed era l'unica volta in cui si andava a mangiare fuori tutti insieme in famiglia. Era un vero evento". La straordinaria parabola umana e professionale di Lorenzo, che unisce ancora oggi l'energia dei palcoscenici alle lunghe sgroppate in bicicletta, sarà presto al centro del cinema. A novembre uscirà infatti nelle sale "Lorenzo - L'incredibile avventura di Jovanotti", un documentario biografico diretto da Dario Zonta e Carlo Zoratti. Il lungometraggio è il frutto di ben sette anni di riprese in cui i registi hanno seguito l'artista passo dopo passo, beneficiando anche del ritrovamento di un prezioso scatolone di vecchi filmati in Super 8 girati dal padre di Lorenzo. Un progetto a cui lo stesso Jovanotti ha voluto partecipare lasciando totale libertà creativa ai due autori: "Per la prima volta nella mia vita non ho avuto il controllo. Ho detto loro: 'Vorrei non vedervi mai'. Io faccio tutto rivolto al futuro, se vogliamo fare un documentario sulla mia storia fatelo voi. Vi do tutto il materiale'. E il film ora è pronto". A 60 anni appena compiuti, la voglia di sperimentare di Lorenzo Cherubini resta intatta. Per Jovanotti il passato è uno scrigno da affidare ai registi, perché il futuro è ancora tutto da inventare.
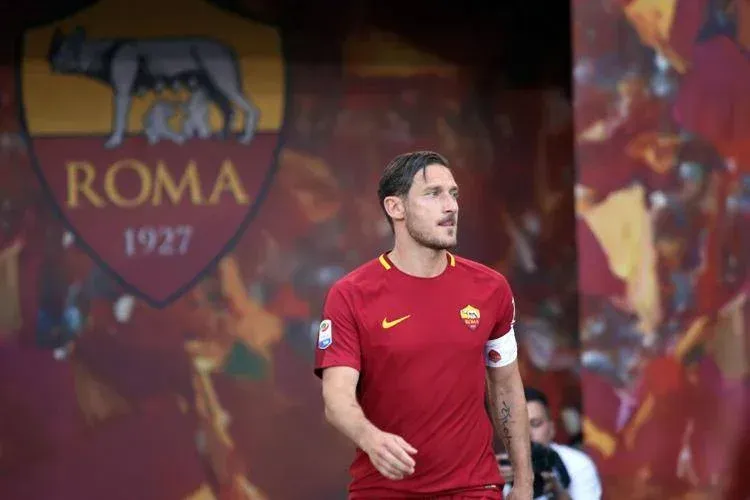
Oggi, 27 settembre 2026, il mondo del calcio e la città di Roma festeggiano un traguardo storico: i 50 anni di Francesco Totti. Mezzo secolo di vita di un’icona assoluta dello sport italiano, un campione capace di legare indissolubilmente il proprio nome a un’unica maglia, quella giallorossa, scrivendo pagine di pura poesia calcistica lungo ventiquattro anni di carriera professionistica. Dall'esordio a soli sedici anni sul campo di Brescia, il 28 marzo 1993 sotto la guida di Vujadin Boskov, fino alla definitiva consacrazione con la fascia di capitano ricevuta a ventidue anni, la parabola del Pupone ha ridefinito i confini del talento e della fedeltà sportiva. Capace di coniugare la visione di gioco del regista puro alla spietata concretezza del bomber, Totti ha guidato la Roma allo storico Scudetto del 2001, ha conquistato la Scarpa d'Oro nel 2007 e si è laureato Campione del Mondo con la Nazionale a Berlino nel 2006. Al di là dei numeri straordinari e dei 307 gol complessivi, a rendere immortale la figura di Francesco Totti è stata la sua clamorosa scelta d'amore: il celebre rifiuto alle lusinghe del Real Madrid per rimanere il simbolo eterno della sua gente. Una scelta di lealtà d'altri tempi che ha trovato il suo culmine emotivo nelle lacrime collettive dello Stadio Olimpico il 28 maggio 2017, giorno del suo commovente addio al calcio giocato. A cinquant'anni suonati, Francesco Totti resta l'emblema di un calcio romantico che non tramonta mai, un patrimonio di classe cristallina che il tempo non potrà mai scalfire. I più sinceri e affettuosi auguri di buon compleanno al Capitano da parte di tutta la Redazione di FRV NEWS MAGAZINE!
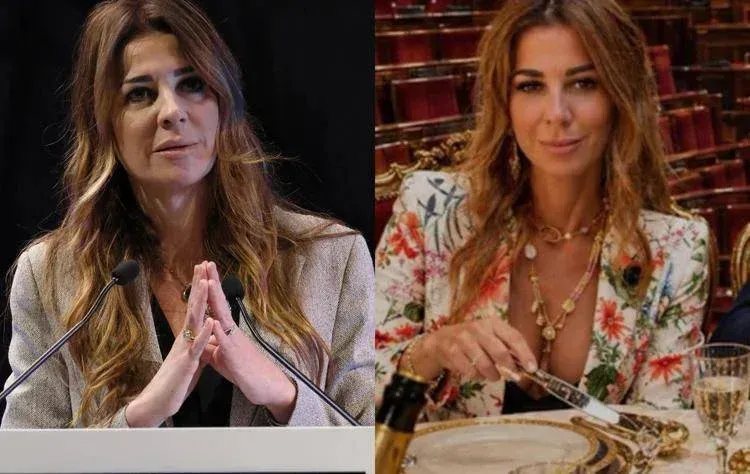
Roberto Vannacci finisce al centro di una dura polemica politica e mediatica dopo aver condiviso sulla propria pagina Facebook una foto della sottosegretaria ai Rapporti con il Parlamento, Matilde Siracusano, modificata tramite l'intelligenza artificiale per alterarne l'abbigliamento ed evidenziarne la scollatura. La deputata di Forza Italia ha reagito con fermezza, definendo l'episodio "un vero e proprio schifo che va arginato" e un attacco denigratorio mirato. Siracusano ha espresso forte preoccupazione per l'utilizzo manipolatorio della tecnologia contro le donne, sottolineando la gravità del gesto poiché compiuto da un esponente politico, e ha annunciato di stare valutando una denuncia legale. Dal canto suo, il generale Vannacci ha respinto le accuse definendole "senza concretezza" e ha successivamente pubblicato un secondo post di chiarimento. Attraverso la condivisione dello scatto originale, il generale ha dimostrato che l'immagine ritoccata proveniva in realtà da un blog esterno, dichiarando di non essere l'autore del fotomontaggio.
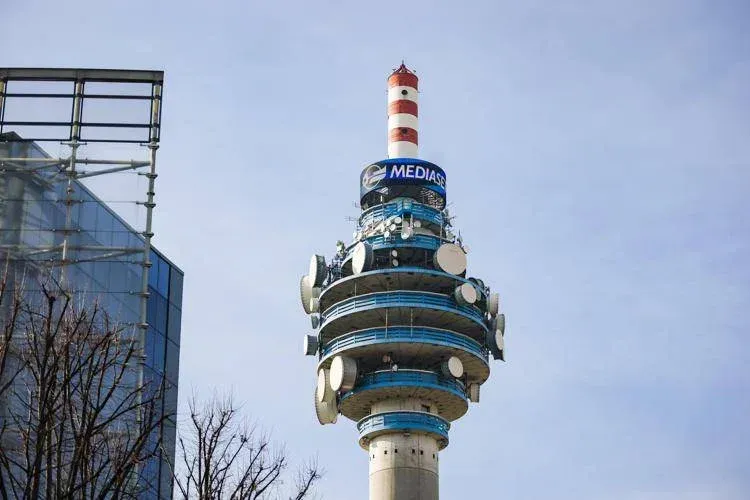
Quasi cinquant'anni di storia industriale e d'innovazione hanno trasformato la televisione commerciale italiana in un gruppo multimediale europeo. Nato nel 1978 con l'inaugurazione di Telemilano da parte del fondatore Silvio Berlusconi, il Gruppo si è evoluto nel tempo fino a diventare MFE-MediaForEurope, un polo paneuropeo strutturato per competere direttamente con le grandi piattaforme globali dello streaming. Oggi la holding opera in modo integrato in sei mercati chiave , che comprendono Italia, Spagna, Germania, Austria, Svizzera e Portogallo, unendo in un unico ecosistema televisione, radio, piattaforme digitali, streaming, produzione di contenuti e raccolta pubblicitaria. La nascita di Canale 5 nel 1980, seguita da Italia 1 e Rete 4, ha gettato le basi del primo polo privato italiano, spingendo il fondatore a esportare il modello commerciale all'estero già nella seconda metà degli anni Ottanta attraverso La Cinq in Francia, Tele 5 in Germania e Telecinco in Spagna. Questa visione transfrontaliera ha vissuto un passaggio fondamentale nel 1996, quando le attività sono state riunite sotto il marchio Mediaset per lo sbarco ufficiale a Piazza Affari a Milano. Il vero e proprio cambio di passo internazionale si è compiuto tra il 2019 e il 2021 con il lancio del progetto MFE, il trasferimento della sede legale ad Amsterdam e l'inizio delle negoziazioni delle azioni di classe A e B su Euronext Milan. Il processo di integrazione societaria ha registrato un'importante accelerazione nel 2023 con l'incorporazione di Mediaset España e il contestuale sbarco delle azioni MFE A sulle Borse spagnole di Madrid, Barcellona, Bilbao e Valencia. Il salto decisivo verso la leadership continentale è avvenuto nel 2025 con la conquista del controllo della tedesca ProSiebenSat.1, uno dei maggiori broadcaster commerciali della Germania quotato alla Borsa di Francoforte, a cui si è aggiunto nel 2026 l'ingresso strategico nel capitale del gruppo editoriale portoghese Impresa. Il progetto industriale di MFE-MediaForEurope dimostra l'efficacia di un modello sinergico unico nel suo genere, capace di preservare le identità editoriali e culturali dei singoli mercati locali e di mettere contemporaneamente in comune tecnologia, piattaforme digitali, know-how e raccolta pubblicitaria per rispondere con efficacia alle sfide digitali globali.
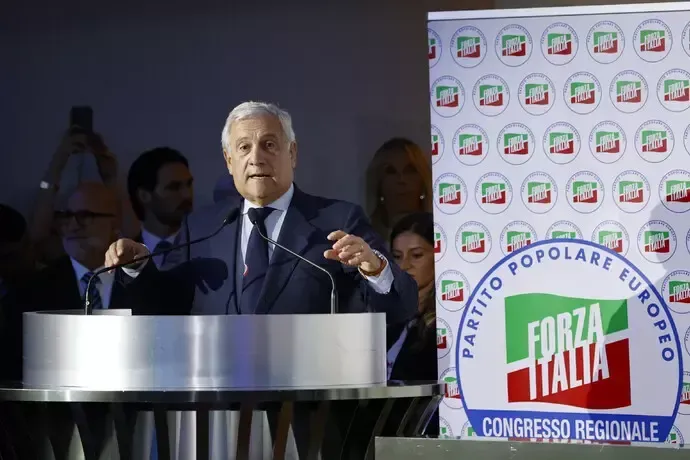
Giovedì il primo voto alla Camera sulle pregiudiziali. Resta alta la tensione politica, in particolare sulle norme per l'alternanza di genere, mentre gli ultimi sondaggi agitano i partiti. Entra nel vivo la partita parlamentare sulla riforma della legge elettorale. Il primo e decisivo banco di prova è fissato per giovedì prossimo, quando l'Aula della Camera sarà chiamata a esprimersi sulle pregiudiziali di costituzionalità presentate dalle opposizioni. Un appuntamento che si preannuncia ad alta tensione, ma che vede i vertici della maggioranza ostentare compattezza. Sul delicato passaggio del voto segreto è intervenuto direttamente il Vicepremier e Ministro degli Esteri, Antonio Tajani, che ha voluto blindare la tenuta della coalizione di governo: “Non temiamo alcuna sorpresa in Aula, non ci sarà nessun franco tiratore”, ha dichiarato il leader di Forza Italia, respingendo l'ipotesi di imboscate parlamentari all'interno dei partiti che sostengono l'esecutivo. Nonostante le rassicurazioni, il clima nei palazzi della politica resta incandescente. A surriscaldare il dibattito sono soprattutto le forti frizioni trasversali sul principio della parità di rappresentanza. Le parlamentari di diversi schieramenti mantengono infatti altissima la pressione sul mantenimento e sul rafforzamento dei meccanismi di alternanza uomo-donna nella composizione delle liste elettorali, un tema considerato non negoziabile. A complicare il quadro si aggiungono le ultime rilevazioni dei sondaggi demoscopici. I dati, in costante evoluzione, stanno modificando i rapporti di forza virtuali tra le liste, alimentando il nervosismo e spingendo le segreterie dei partiti a ricalibrare le proprie strategie in vista dello showdown di giovedì.
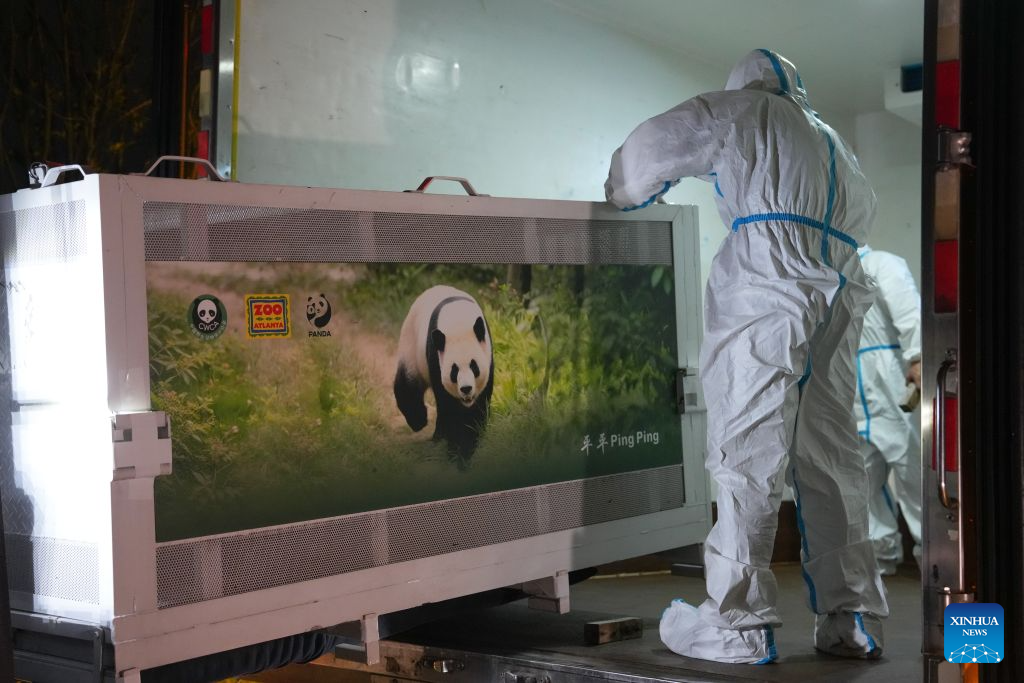
A darne notizia è l'agenzia di stampa cinese Xinhua. I due esemplari sono decollati da Chengdu a bordo di un volo charter sotto la supervisione di veterinari ed esperti internazionali Foto Agenzia Cinese Xinuha ROMA – Una nuova coppia di panda giganti ha lasciato la Cina con destinazione Stati Uniti. A darne l’annuncio ufficiale è l’agenzia di stampa statale cinese Xinhua, citando la National Forestry and Grassland Administration: i due esemplari, il maschio Ping Ping e la femmina Fu Shuang, sono decollati dall’aeroporto internazionale di Chengdu Shuangliu alle 2:55 di notte di domenica 27 settembre a bordo di un volo charter diretto verso lo Zoo di Atlanta, dando il via a un programma di permanenza e ricerca scientifica della durata di dieci anni. L’ANNUNCIO DI XI JINPING E IL VALORE DELLA DIPLOMAZIA DEI PANDA Il trasferimento dei due esemplari era stato concordato da tempo tra le diplomazie dei due Paesi, ma la partenza è stata ufficialmente annunciata giovedì durante la visita del presidente cinese Xi Jinping a Washington. Un passaggio strategico dal forte valore simbolico: questi mammiferi bianchi e neri godono infatti di un’enorme popolarità in tutto il mondo e la Cina li concede in prestito nell’ambito del consolidato programma di “diplomazia dei panda”, uno storico strumento di soft power finalizzato a favorire i legami con l’estero, distendere le relazioni internazionali e promuovere la cooperazione culturale. IL VIAGGIO TRANSOCEANICO E LE MISURE DI SICUREZZA Prima della partenza, la base di ricerca per la riproduzione del panda gigante di Chengdu ha organizzato una cerimonia ufficiale di saluto per Ping Ping (un maschio nato il 17 marzo 2020) e Fu Shuang (una femmina nata il 18 ottobre 2020). Come riportato dalle autorità cinesi alla stampa ed edito da Xinhua, l’intera spedizione transpacifica è stata pianificata nei minimi dettagli per azzerare lo stress degli animali: a bordo dell’aereo sono stati stivati ingenti quantitativi di bambù fresco, germogli, mele e forniture mediche di emergenza, mantenendo costanti temperatura e umidità della stiva. A scortare i due panda nel volo transoceanico sono presenti veterinari e keeper americani, affiancati da team specialistici giunti dalla Cina ad Atlanta. Una volta atterrati in Georgia, i due animali affronteranno un periodo di quarantena e controlli sanitari, durante il quale gli esperti cinesi rimarranno all’interno dello zoo per assistere i colleghi statunitensi nell’acclimatazione dei plantigradi. IL RINNOVAMENTO DELLE STRUTTURE E VENT’ANNI DI COLLABORAZIONE L’arrivo di Ping Ping e Fu Shuang è il frutto di un lungo lavoro preparatorio. Secondo quanto riferito dai report diffusi dall’agenzia Xinhua, gli esperti della base di Chengdu e i tecnici dello Zoo di Atlanta hanno collaborato a stretto contatto sin da dicembre 2025 per rinnovare gli habitat della struttura americana. L’impianto aggiornato dispone ora di un’area espositiva al coperto ampliata, piattaforme di arrampicata, piscine e sistemi di monitoraggio ambientale avanzati. L’operazione rafforza oltre vent’anni di cooperazione scientifica tra la Cina e lo Zoo di Atlanta nel campo della conservazione della specie, un sodalizio che ha già portato alla pubblicazione di oltre 50 studi accademici e alla nascita congiunta di sette cuccioli di panda gigante.
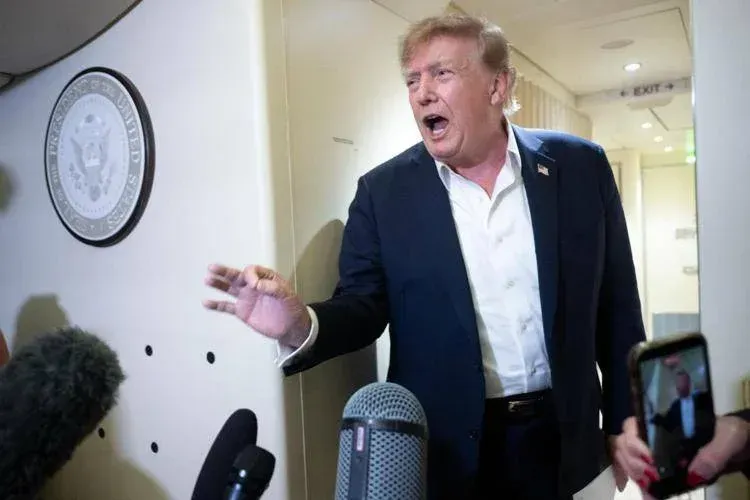
Guerra in Ucraina: Trump spinge per un accordo entro l'inverno, ma resta lo stallo diplomatico tra Kiev e Mosca Le recenti dichiarazioni dei leader internazionali delineano uno scenario geopolitico complesso e frammentato sul futuro del conflitto russo-ucraino. Nonostante il forte pressing diplomatico esercitato dagli Stati Uniti per raggiungere una rapida risoluzione, le posizioni sul campo e nelle cancellerie restano profondamente distanti. Il Presidente degli Stati Uniti, Donald Trump , a seguito del lungo colloquio bilaterale avvenuto a New York con il Presidente ucraino Volodymyr Zelensky, ha espresso un cauto ottimismo circa la possibilità di un’intesa formale. "Putin e Zelensky potrebbero fare un accordo nel breve futuro, forse già prima del pesante inverno", ha dichiarato il capo della Casa Bianca, sottolineando l'urgenza di fermare un bilancio umano drammatico che solo nell'ultimo mese ha registrato circa 25.000 vittime complessive tra le due parti. La presidenza statunitense mira a favorire un incontro diretto tra i due leader, sebbene l’ufficio di Zelensky abbia categoricamente smentito le indiscrezioni riguardanti una pressione della Casa Bianca per un viaggio del presidente ucraino a Mosca. La visione di Washington non trova tuttavia riscontro a Kiev. Il Presidente Volodymyr Zelensky ha ribadito la ferma diffidenza dell'Ucraina nei confronti delle reali intenzioni del Cremlino, evidenziando come i russi non stiano mostrando alcun segnale concreto di voler cessare le ostilità. Secondo la leadership ucraina, la Federazione Russa prosegue nei suoi piani militari senza alcuna reale apertura a una pace giusta e duratura. A inasprire ulteriormente i toni si aggiungono le dichiarazioni del Ministro degli Esteri russo, Sergey Lavrov , che ha accusato apertamente l'Occidente di "sognare la sconfitta di Mosca" e ha affermato che l'Europa si starebbe progressivamente preparando a un'escalation militare diretta. Allo stato attuale, la prospettiva di una svolta negoziale immediata rimane incerta. Gli Stati Uniti continuano a spingere per un compromesso entro la fine dell'anno, ma lo scetticismo di Kiev e la retorica bellica di Mosca confermano una profonda distanza tra le parti coinvolte.